「他のミレニアム問題(ホッジ予想)まで、OpenAIが解きそう(解いた?)という怪情報が流れてます」。2026年9月10日、AI研究者の今井翔太氏はX(旧Twitter)にこう投稿しました。
同じ日の英語圏のXには、「この48時間の噂は、OpenAIがホッジ予想を解き、AnthropicがBSD予想を解いた、というものだった」という投稿も流れています。ホッジ予想もBSD予想も、100万ドルの懸賞金がかかった7つの「ミレニアム懸賞問題」のひとつです。
日本時間9月13日、予測市場Kalshiに「次に解かれるミレニアム問題はどれか(2045年まで)」という賭けが立つと、1ドルで決済される「BSDが次」の契約は、14日に一時92セントで売買されました。海外のテック系メディアは「38ポイント上昇」と報じています。しかし、その取引の総額は数百ドル規模にすぎず、値は日本時間18日には1セントまで落ちました。
そして10月6日(米国時間)、OpenAIは実際に、BSD予想の名前を題に含む94ページの論文を公開しました。噂に身構えていた人も、「また難問が解けたのか」と見出しだけを読んだ人も、同じ問いの前に立たされています。
本当に、解けたのでしょうか。
10月6日の722本の原稿の中に「BSD」の論文があった
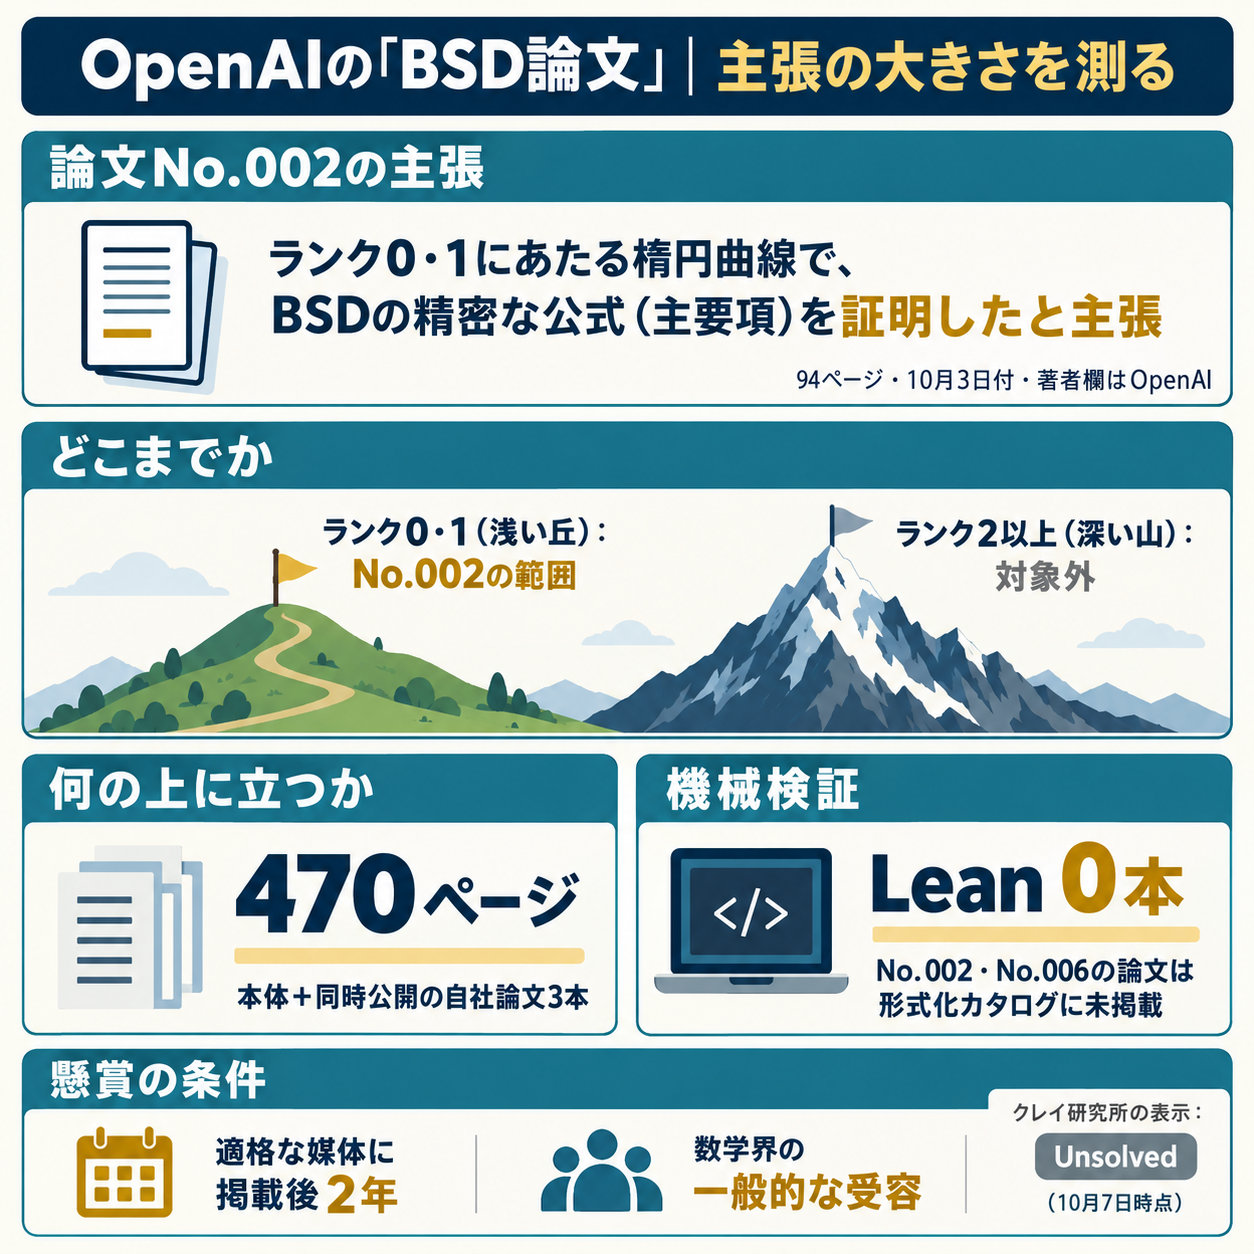
OpenAIはこの日、社内の未公開モデルが生み出したとする数学の原稿722本を、GitHubのリポジトリ「openai/math」で公開しました。関連する原稿は372の「ファミリー」に束ねられ、その2番目に置かれたのが、今回の主役である「The full BSD formula from low Selmer corank(低いセルマー余階数からの完全なBSD公式)」です。
本体の論文は10月3日付、著者欄は「OpenAI」です。要旨はこう始まります。
We prove the full Birch–Swinnerton-Dyer leading-term formula for every elliptic curve over Q whose full q-power Selmer group has corank zero or one at some prime q.
(ある素数 q において q冪セルマー群全体の余階数が0または1となる、Q上のすべての楕円曲線について、バーチ–スウィナートン=ダイアーの主要項公式を完全な形で証明する。)
意外なことに、OpenAIの公式ブログが書いたのは「幅広い新しい数学的結果」という言葉だけで、BSDとミレニアム懸賞への言及はゼロです。海外メディアには「OpenAI、未公開AIモデルが数学の問題372件を解いたと発表」という見出しも出ましたが、372は「問題の数」ではなく「ファミリーの数」です。数字も主語も、伝わる途中で少しずつ形を変えています。
BSD予想は「宝探しの金属探知機」の予想
BSD予想の舞台は、y² = x³ + ax + b という形の曲線です。「楕円曲線」と呼ばれます。
この曲線の上で、x も y も分数(有理数)になる点を探します。そうした点を「宝」と呼ぶことにすると、BSD予想は宝の量についての予想です。
なぜ「2乗と3乗」なのか
宝探しの難しさは、曲線の次数で大きく変わります。円や放物線のような2次の曲線は、宝があるかどうかの判定法も、宝を全部書き出す方法も、古くから分かっています。反対に、もっと込み入った曲線(数学の言葉で「種数2以上」)では、宝は有限個しかないことを、1983年にファルティングスが証明しました。
y² = x³ + ax + b は、そのちょうど中間にあります。宝が有限個で終わる曲線もあれば、無限に湧き出す曲線もあり、どちらになるかを見分ける一般的な方法は、いまも未発見です。
1つの宝から次の宝を作る
楕円曲線には、宝から宝を作る仕組みがあります。たとえば y² = x³ − 2 の上の点 (3, 5) で接線を引くと、接線は曲線ともう一度ぶつかり、その点の座標は (129/100, 383/1000) という分数になります。
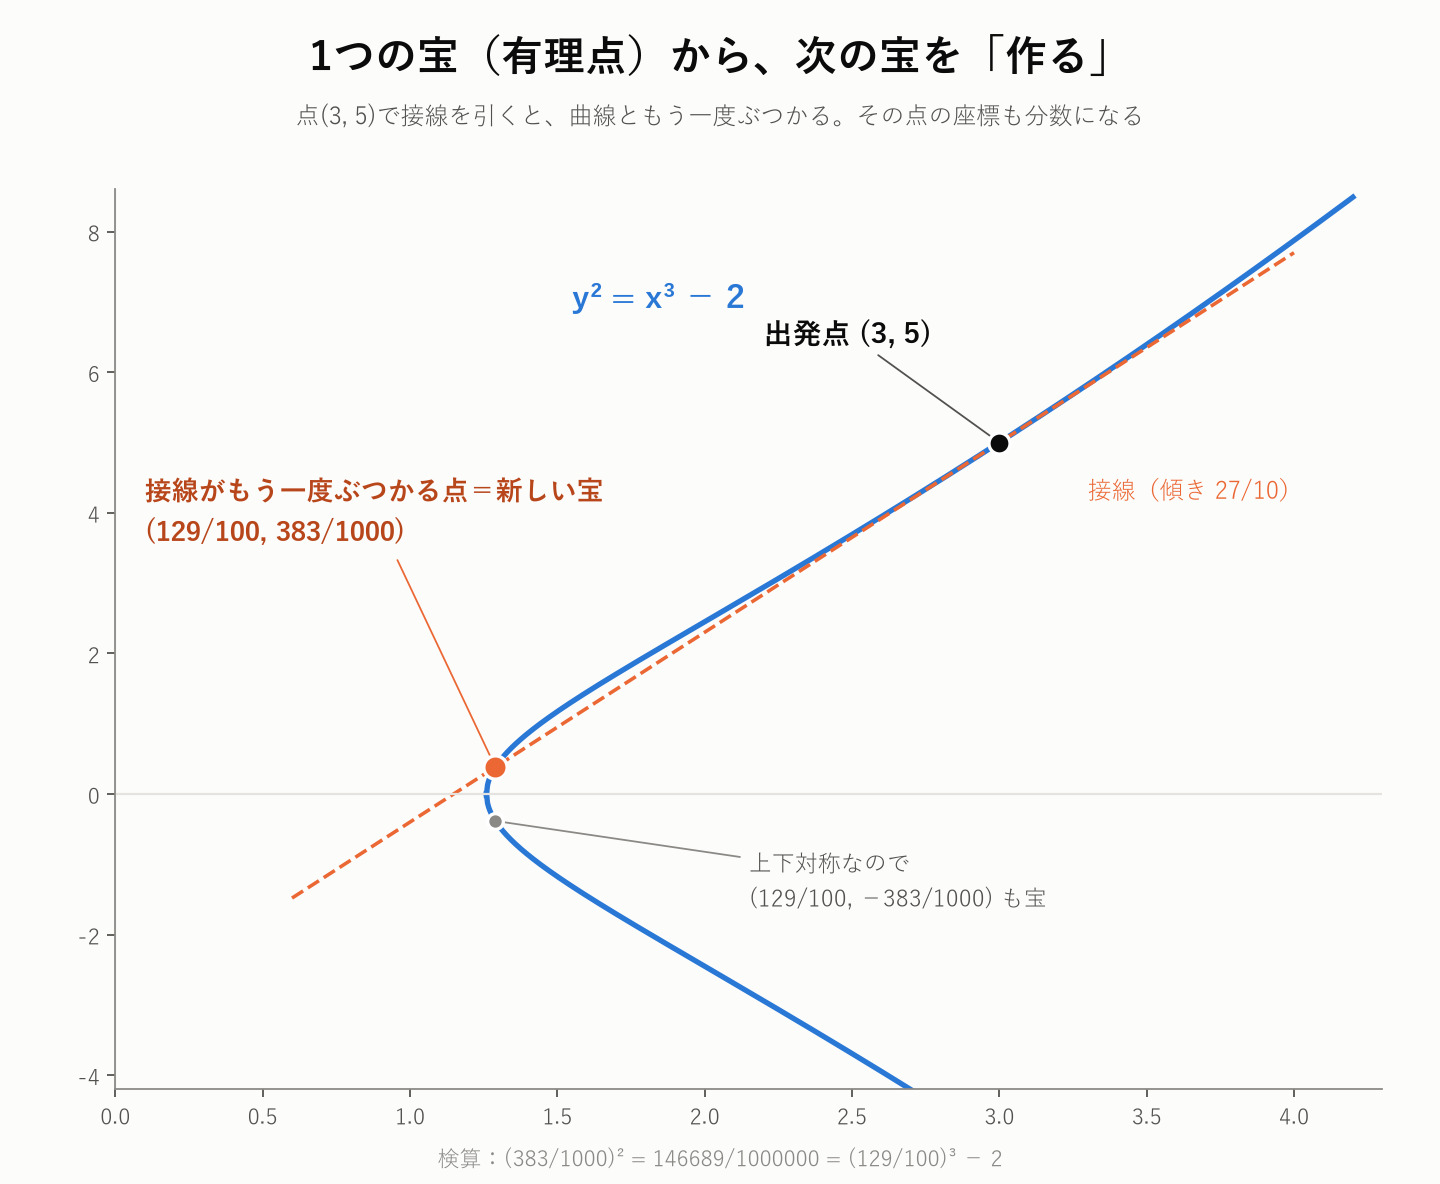
こうして増やしていくと、どの楕円曲線でも、有限個の「種」から全部の宝を作り出せることが知られています(モーデルの定理、1922年)。種が何個要るかを「ランク」と呼びます。ランクが0なら宝は有限個、ランクが1以上なら無限にあります。
金属探知機の正体はL関数
1960年代の初め、バーチとスウィナートン=ダイアーは、ケンブリッジ大学の初期の計算機EDSACで大量の計算をしました。曲線ごとに、素数で割った余りの世界で点を数え、その数から「L関数」という関数を組み立てたのです。
すると、L関数が s = 1 という地点で0になるとき、宝が無限にあるように見えました。しかも、0への潰れ方の深さ(零点の位数)が、ランクと一致しているように見えたのです。
ランクという「埋まっている種の数」を、L関数という「金属探知機の反応の深さ」で読み取れる。これがBSD予想の主張です。
ただし、点の数から組み立てたままのL関数は、s = 1 の地点ではそもそも値が定まりません。そこまで関数を延ばせると保証しているのが、サイモン・シンの『フェルマーの最終定理』でおなじみの「谷山–志村予想」、つまり「すべての楕円曲線はモジュラーである」という定理です。ワイルズが、テイラーとの共著論文とあわせて1995年にフェルマーを解くのに必要な場合を証明し、2001年にブルイユ、コンラッド、ダイアモンド、テイラーが全体を完成させました。
OpenAIの論文も4ページ目で、この3つのモジュラリティ定理が「すべての楕円曲線のL関数の解析接続と関数等式を与える」と明記しています。フェルマーを解いた定理は、今回のBSD論文でも土台の一部です。
面積5の三角形とつながっている
この予想は、800年ほど前の問いにもつながっています。3辺がすべて分数の直角三角形で、面積がちょうど5になるものはあるでしょうか。13世紀、フィボナッチは神聖ローマ皇帝フリードリヒ2世の宮廷でこの問題を出され、答えを見つけました。
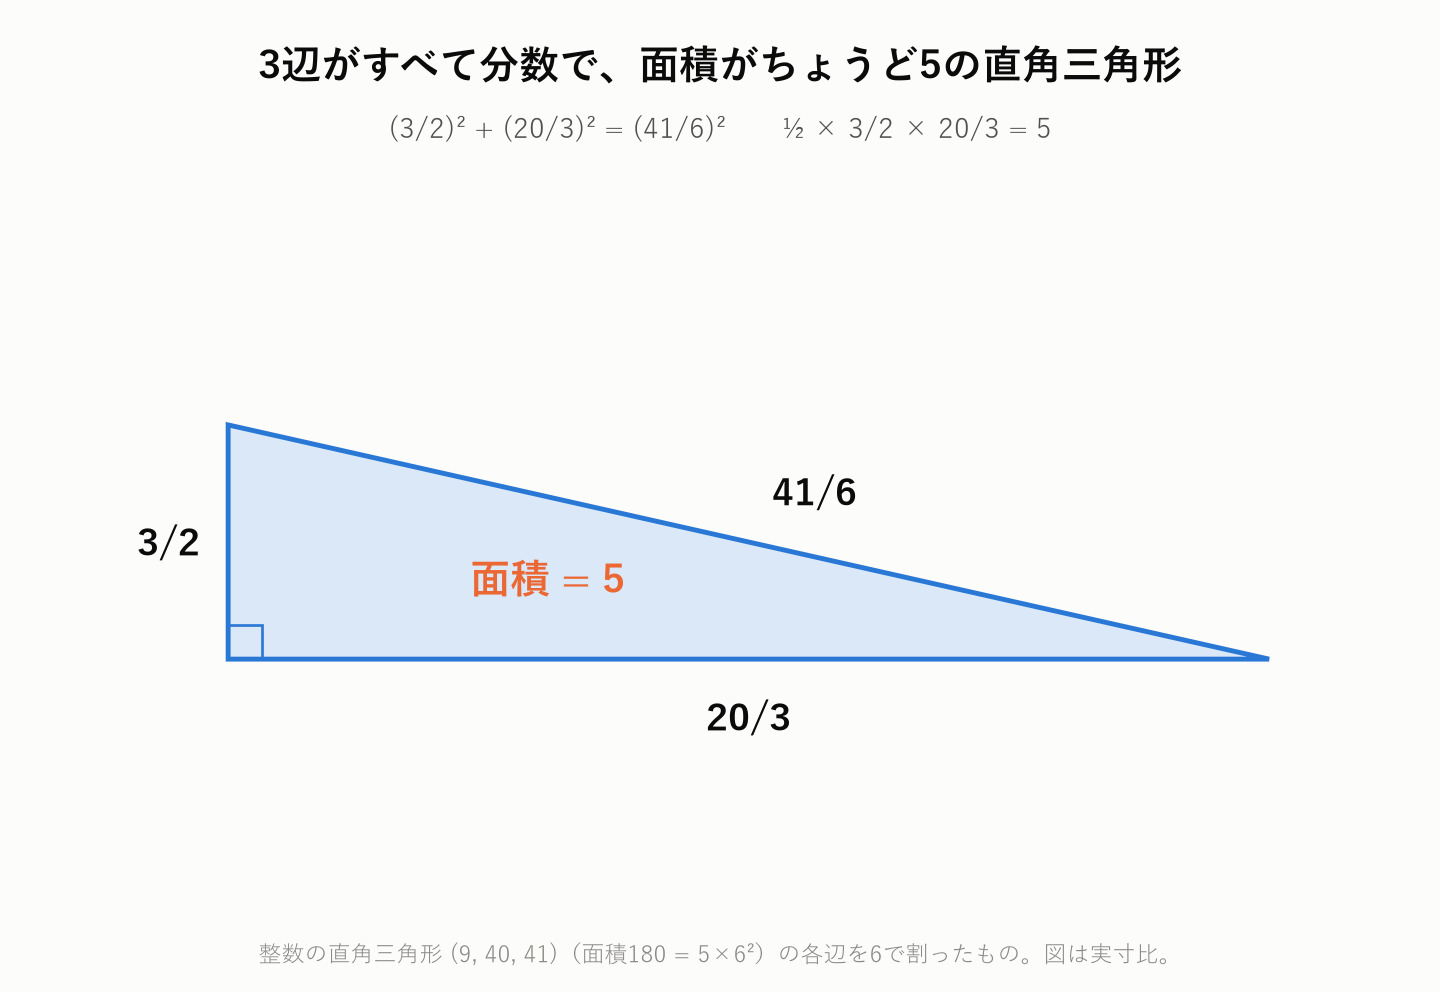
面積が1の三角形は存在しないことを、フェルマーが証明しています。面積が n の三角形があるかどうかは、y² = x³ − n²x という楕円曲線に宝が無限にあるかどうか、という問いと同じになります。
見出しだけを信じると何を失うか
数学の話は自分に関係ない、と感じる方も多いはずです。しかし「AIが難問を解いた」という見出しは、すでにお金と評判を動かしています。
冒頭の予測市場の動きがその例です。報じた記事自身が、BSDをめぐる主張は「研究所の発表ではなく、一人の利用者の予測に遡る」と書いています。その噂ひとつで、始まったばかりの薄い市場の値が大きく振れました。
見出しの短縮も起きています。同じ記事の見出しは「BSDは2045年までに解かれるか」の賭け率が上がった、と読めますが、本文が説明する賭けの問いは「次に解かれるのがBSDか」でした。
失うものは、お金のほかにもあります。誤った見出しを社内のチャットで共有すれば、その分だけ自分の言葉の信用が目減りします。
さらに大きな損失は、本当の中身を見逃すことです。後述するとおり、OpenAIのNo.002は、主張どおりなら相当に大きな前進です。「解いた」か「解いていない」かの二択で読むと、その価値の正確な大きさが、かえって見えなくなります。
フィールズ賞受賞者のテレンス・タオは、公開当日にこう書いています。
a problem that has been "solved" cannot be somehow reverted to become "unsolved"
(一度「解かれた」問題を、「未解決」に戻すことはできない。)
一度貼られた「解決」のラベルは、はがれにくいものです。それゆえ、貼る前に確かめる手順が要ります。
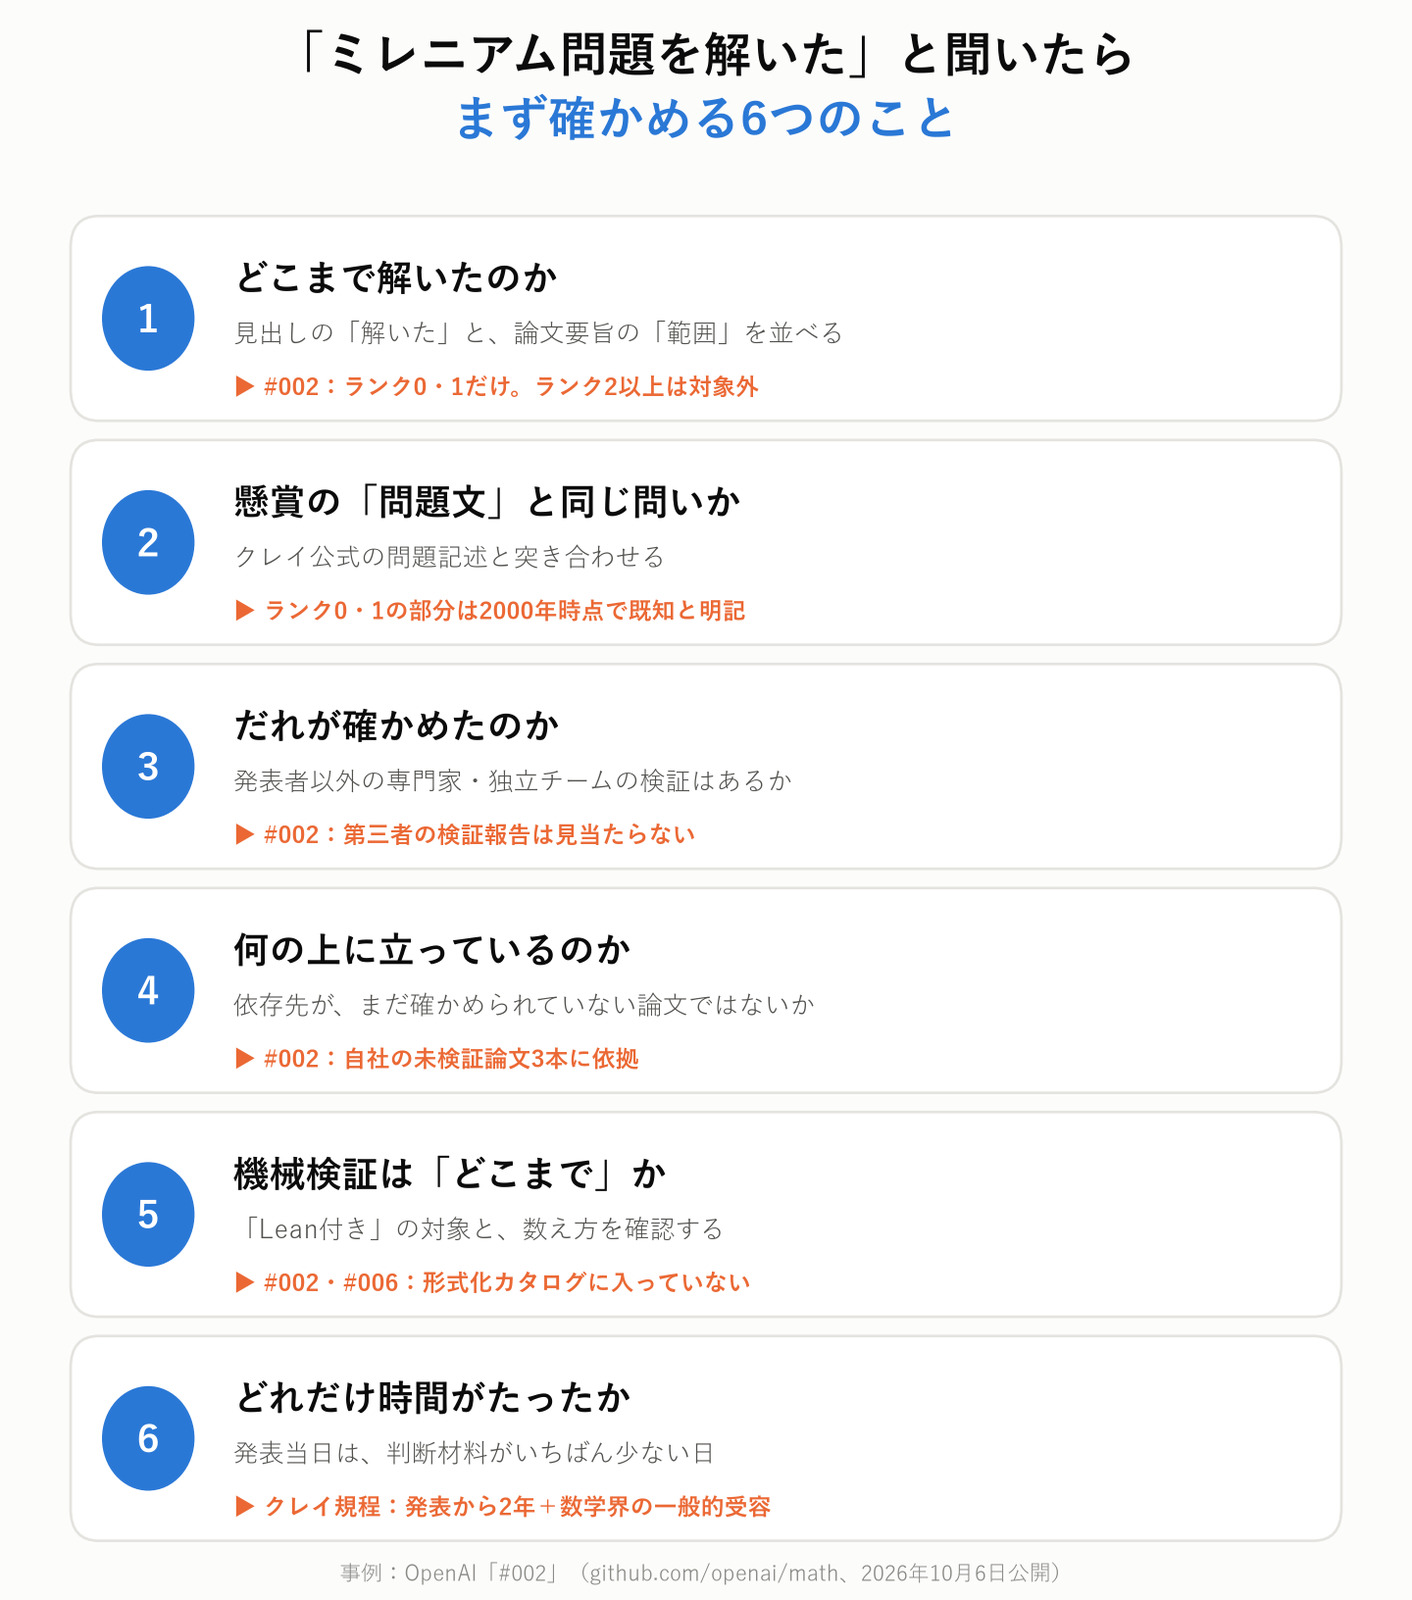
確かめること1:どこまで解いたのか
最初に見るべきは、見出しの「解いた」と、論文の要旨に書かれた「範囲」の差です。OpenAIのNo.002の条件は「ある素数でセルマー余階数が0か1」です。
専門用語を外して言えば、この条件を満たす曲線は、結論としてランクが0か1になります。つまり対象は、種が0個か1個の曲線だけです。
ランク2以上の曲線は、この論文の対象外です。論文自身も3ページ目で、範囲をはっきり書いています。
The low-Selmer-corank hypothesis is essential to the stated scope
(低セルマー余階数の仮定は、述べた適用範囲にとって欠かせない。)
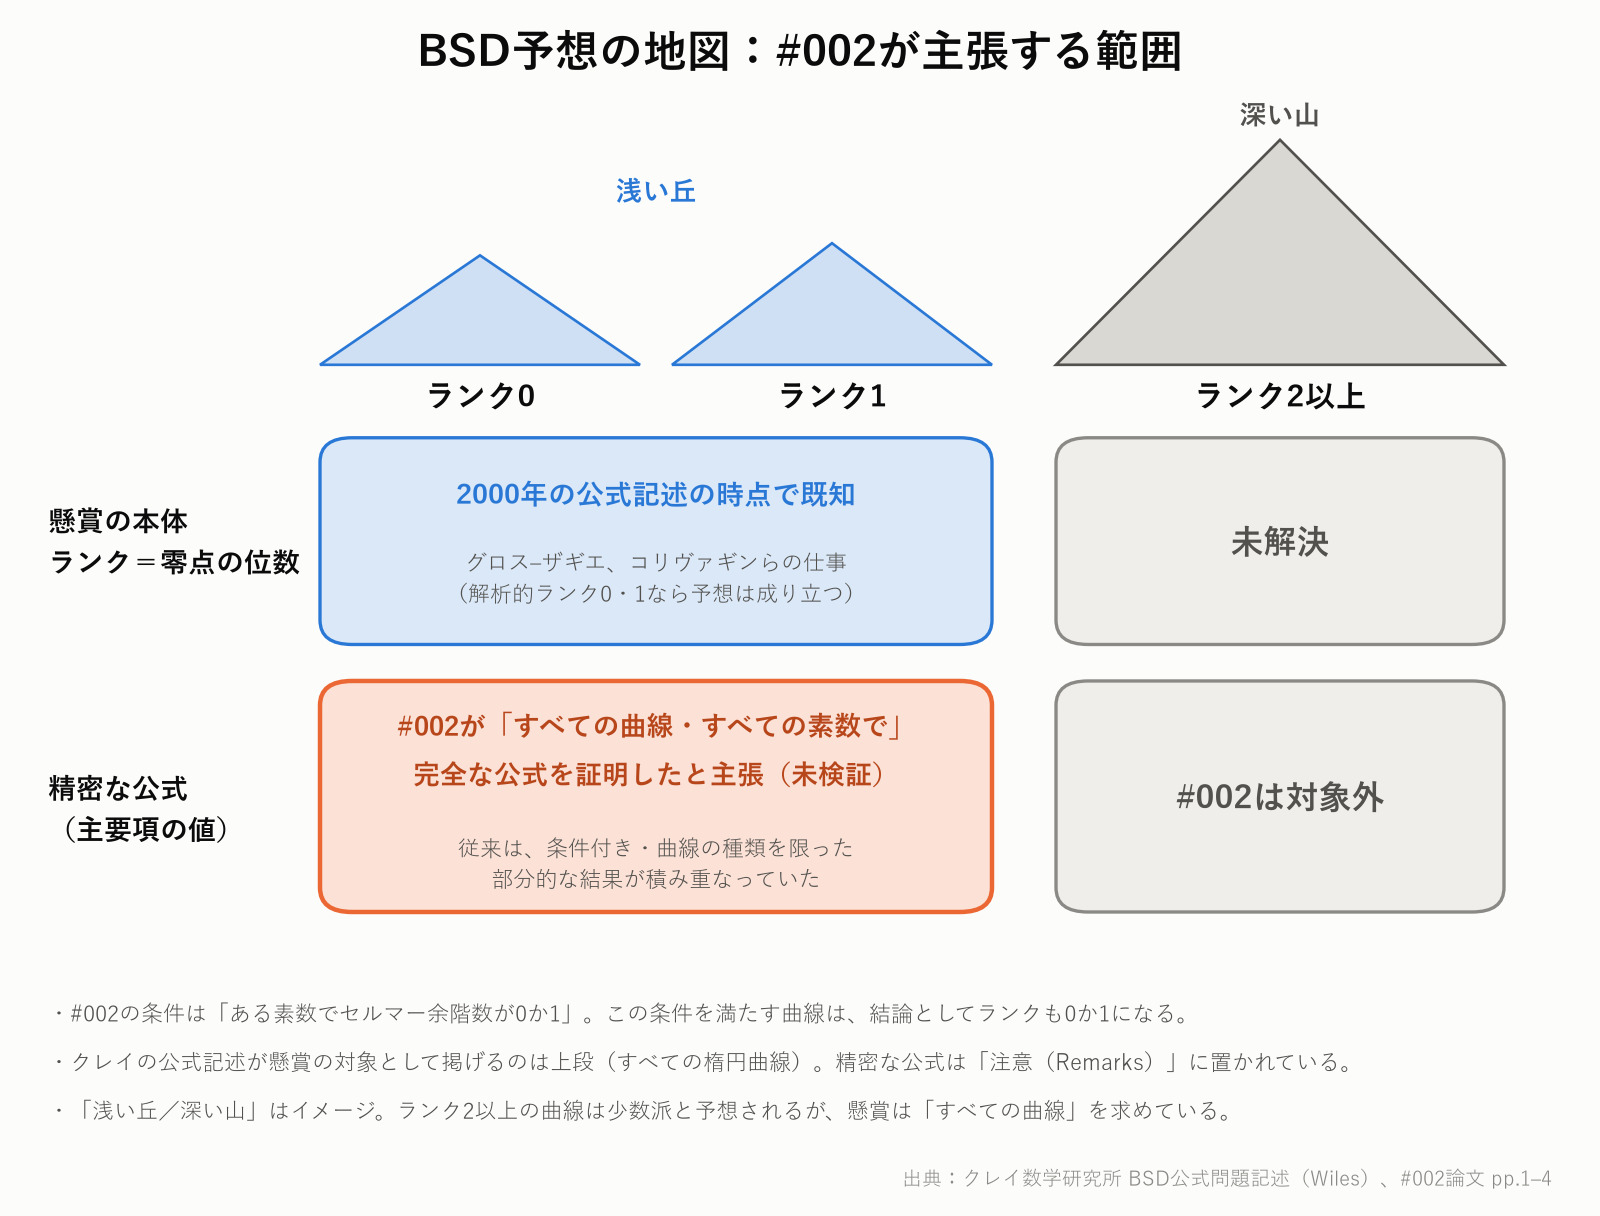
山にたとえると、No.002は「浅い丘(ランク0と1)の完全な測量」を主張する論文です。深い山(ランク2以上)の頂上は、いまも未踏です。
公平のために付け加えると、浅い丘の測量でも、これまでは曲線の種類や素数ごとに条件付きの結果が積み重なっている段階でした。それを「すべての曲線、すべての素数で、追加の仮定なし」と言い切っている点が、No.002の主張の大きさです。
面積5の三角形の問題は前進したのか
面積 n の三角形があるかどうかの判定は、金属探知機が反応しない曲線と、反応が1段の曲線については、すでに決着がつく仕組みが知られています。決着がついていない難しいケースは、金属探知機の反応が2段以上深い曲線に残っています。論文No.002の範囲はランク1までなので、こうした残された難しいケースは論文の範囲の外側にあります。
一方、面積の問題に出てくる曲線は、y² = x³ − x の「ツイスト」と呼ばれる仲間の一家です。No.002と別の論文No.006を組み合わせた「すべての楕円曲線について、ツイストの密度1で完全なBSD」という主張は、形の上ではこの一家にも及びます。割合の話としてどこまで新しいのかについては、この分野の先行研究との関係も含め、専門家の論評は、確認できた範囲ではまだゼロです。
確かめること2:懸賞の「問題文」と同じ問いか
ミレニアム懸賞には、クレイ数学研究所が公開している公式の問題記述があります。BSD予想の記述を書いたのは、フェルマーの最終定理を証明したアンドリュー・ワイルズです。
その記述が懸賞の対象として掲げるのは、「L関数の零点の位数=ランク」という主張を、すべての楕円曲線について示すことです。主要項の精密な公式(No.002が主張する部分)は、本文ではなく「注意(Remarks)」の中に置かれています。さらに同じ記述には、2000年の時点で次のように書かれています。
Theorem. If L(C, s) ∼ c(s − 1)^m with c ≠ 0 and m = 0 or 1, then the conjecture holds.
(定理:零点の位数 m が0または1ならば、予想は成り立つ。)
つまり、零点の位数が0か1の場合(浅い丘)の「懸賞の本体」は、懸賞が発表された時点ですでに分かっていました。No.002が新しく主張するのは、その丘の上での「精密な値」です。
クレイの規程は、公式の問題記述に定められた問いに答えない論文は、密接に関連する問いを扱っていても解決候補とみなさない、と定めています。10月7日時点でも、クレイのBSDのページの表示は「Unsolved(未解決)」のままです。
確かめること3:だれが確かめたのか
発表した本人以外の専門家が検証したかどうかは、数学に限らず、主張の信頼性を測る基本の物差しです。論文No.002について、公開から1日の時点で、第三者の専門家による検証報告は、確認できた範囲ではゼロです。
BSDに関する専門家の発言として見つかるのは、公開前の噂の段階でのものです。数論の研究者ピエール・コルメは、9月にこう書いていました。
Maybe they can prove that BSD is true for 100% of elliptic curves (asymptotically), but this would not bring us 1mm closer to a proof of BSD.
(ひょっとすると楕円曲線の100%(漸近的な意味で)についてBSDが正しいことは証明できるかもしれないが、それではBSDの証明に1ミリも近づかない。)
これはNo.002の公開前、噂の段階での評価です。しかし「割合で言えばほとんどの曲線」と「すべての曲線」の間には大きな距離がある、という専門家の感覚はよく伝わります。
公開当日には、数学者フランク・カレガリが自身のブログで、AIへの「試験問題」を出して採点しました。出題には「任意のランクでの、完全な形のBSD予想」が含まれていましたが、当日の採点の追記で点が付いたのは、BSDとは別の2項目でした。出題が「任意のランク」を求めていた以上、ランク1までのNo.002に点が付かないのは、範囲の確認として筋が通っています。
数学者らによる諮問グループAGMAIも、公開当日の声明でこう書いています。
This release is the beginning, not the completion, of the process of human understanding
(この公開は、人間による理解の過程の始まりであって、完了ではない。)
確かめること4:何の上に立っているのか
大きな証明は、たいてい既存の結果を土台にしています。土台が確かめられた結果なのか、まだ確かめられていない結果なのかで、上に建つものの安定感は大きく変わります。
論文No.002の本体は、ランクと有限性の部分について、同時に公開された自社の論文に任せています。論文自身が、3ページ目で次のように書いています。
The rank and finiteness assertions are the unrestricted low-corank converse of [23]; the two-primary leading-term equality is supplied by [24].
(ランクと有限性の主張は[23]の逆定理によるもので、2の部分の主要項の等式は[24]が与える。)
[22][23][24]はいずれもOpenAI名義の論文で、どれも同じ時期に公開されたばかりです。No.002自体が新しく証明したと書いているのは「すべての奇素数での正確な値」の部分です。
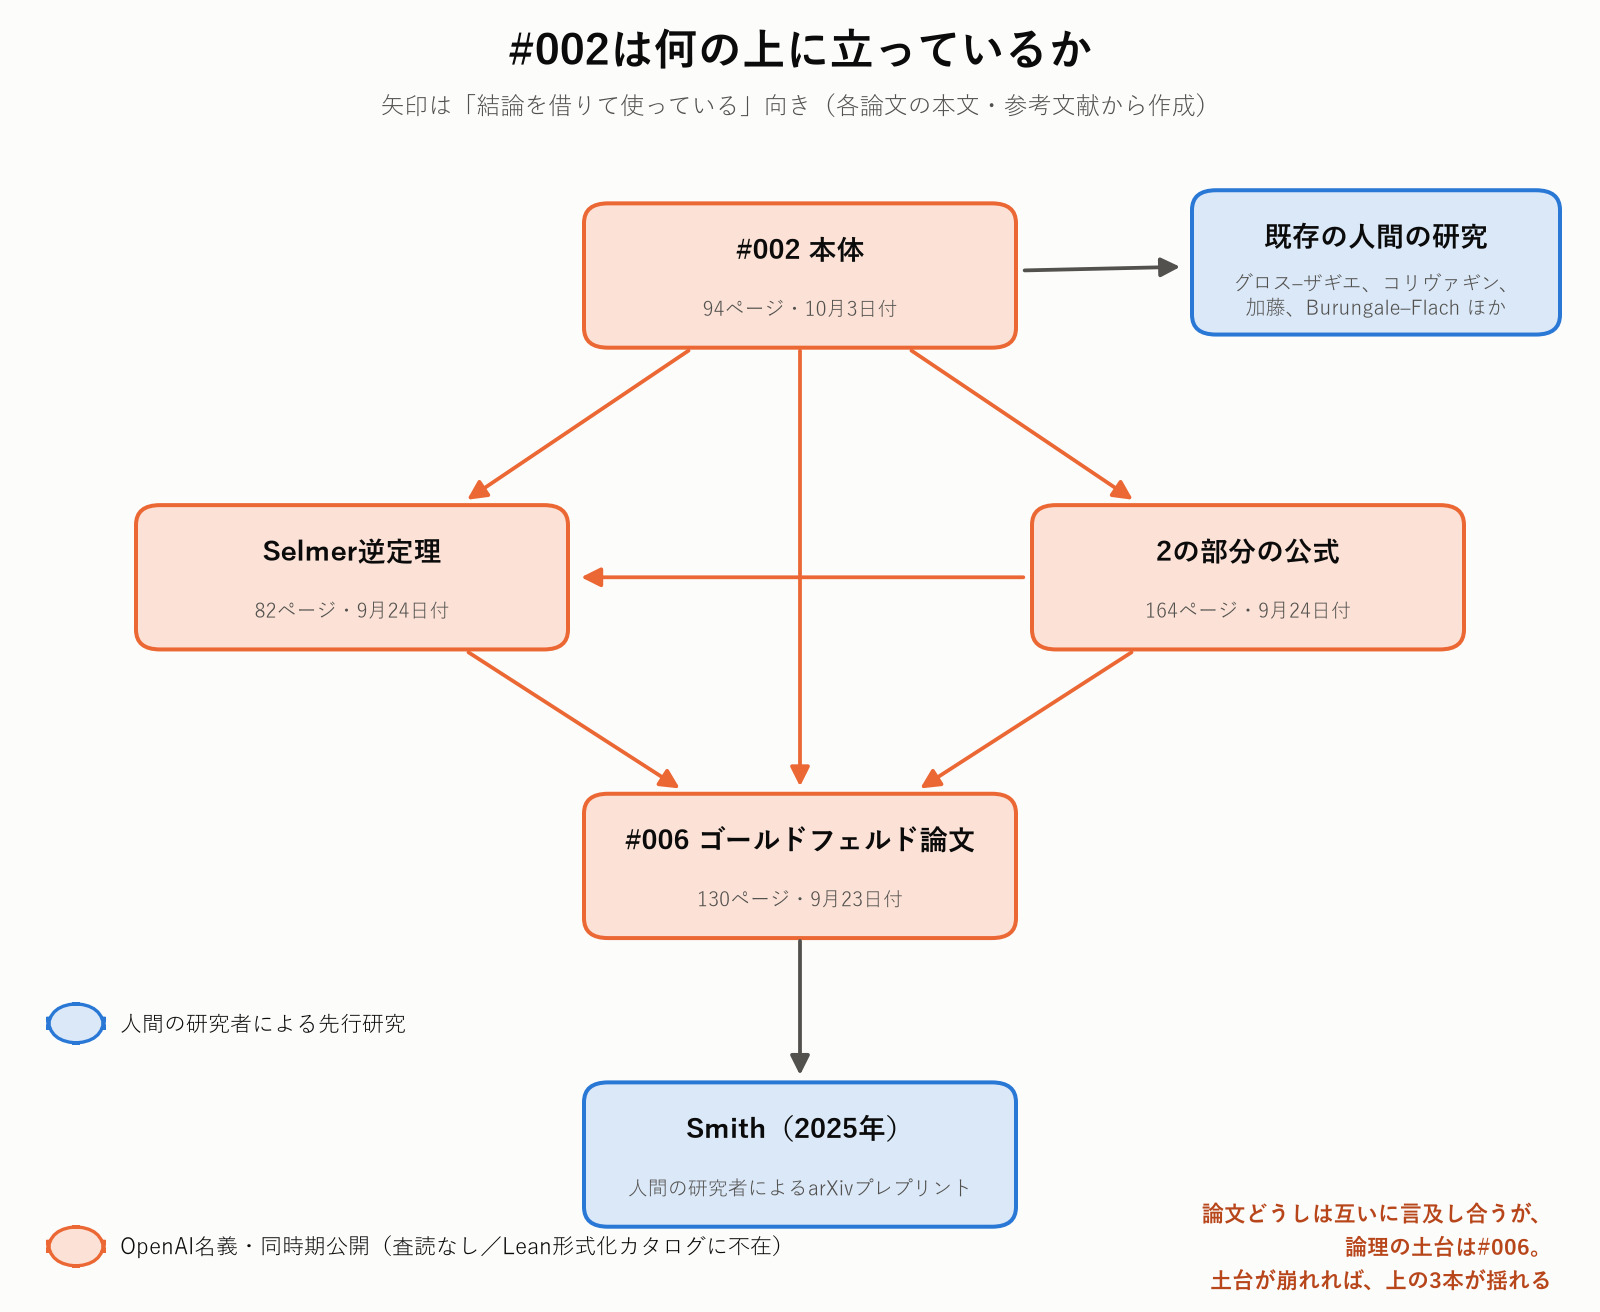
依存関係をたどると、土台にあるのはNo.006のゴールドフェルド論文(130ページ)で、それがさらに数学者アレクサンダー・スミスの2025年のプレプリントに依拠しています。本体と同伴論文2本、No.006のゴールドフェルド論文を合わせると、470ページにのぼります。
論文どうしは互いに言及し合っていますが、論理の流れはNo.006を土台にした積み上げです。土台の1本に穴が見つかれば、上の3本がすべて揺れます。
細かな点ですが、本体の4ページ目には「[24, 23, ?]」という引用があります。「?」は、組版ソフトが参照先を見つけられなかったときに出る記号です。数学の誤りではありませんが、原稿がまだ仕上げの途中にあることを示すサインとして読めます。
確かめること5:機械検証は「どこまで」か
今回の公開で注目されたのが、Leanという言語による「形式化」です。証明をプログラムとして書き直し、コンピューターに論理の正しさを検査させる方法です。ここで注意したいのは、「Lean付き」の数え方です。
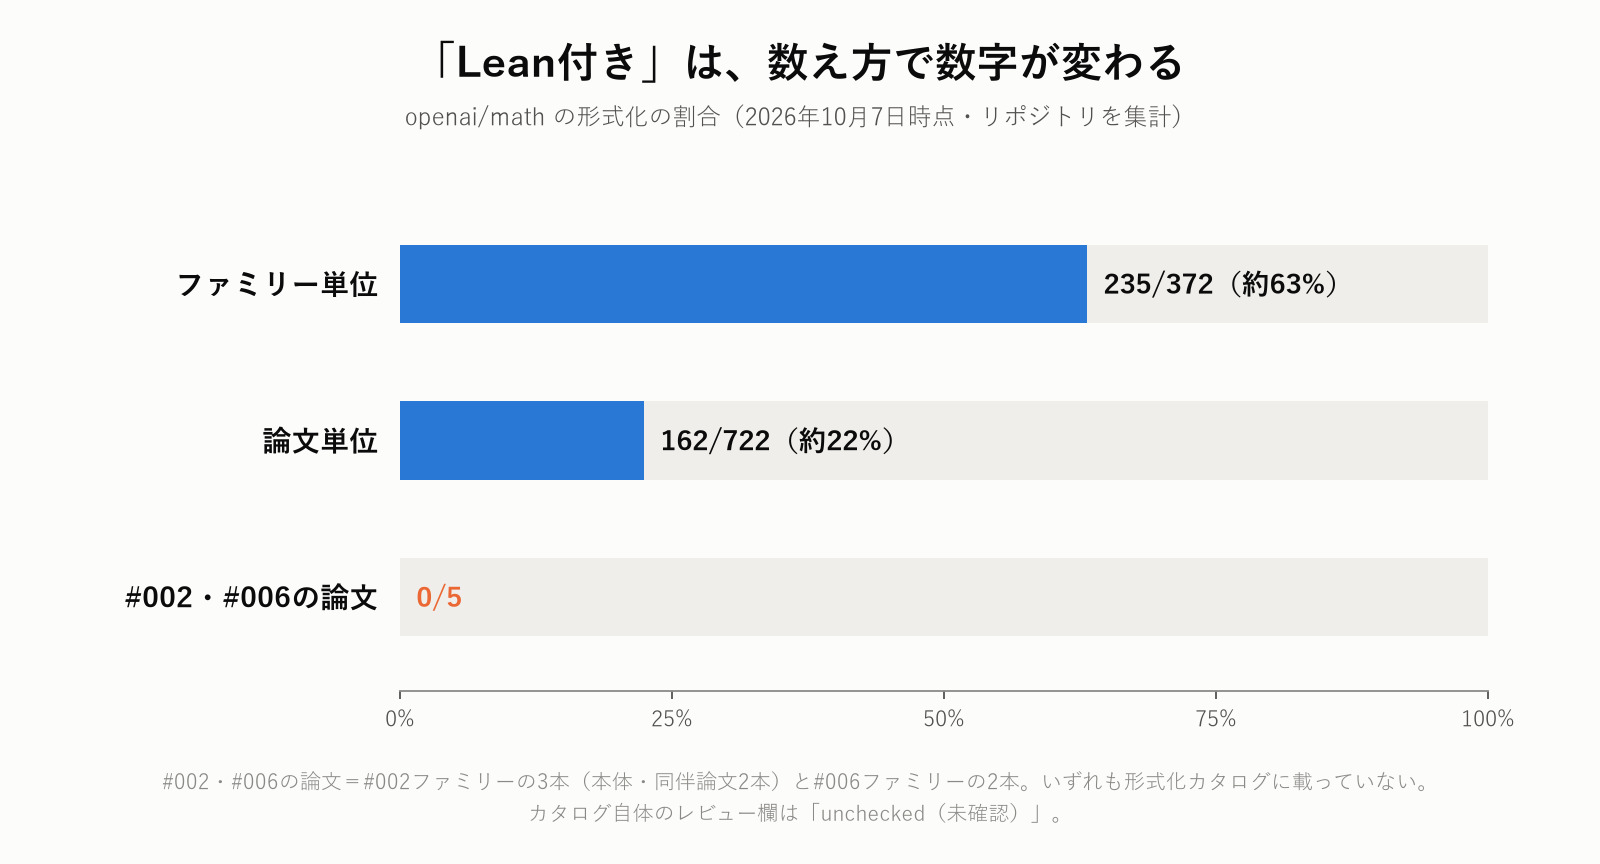
ファミリー単位で数えると、372のうち235(約63%)にLeanの文書へのリンクがあります。しかし、主結果が形式化された論文を集めたカタログで数えると、722本のうち162本(約22%)です。報道によって、どちらの数字を使っているかが違います。
そしてこのカタログに載ったNo.002とNo.006の論文は、ゼロ本です。カタログのレビュー欄の値も「unchecked(未確認)」です。OpenAI自身も、リポジトリの説明にこう書いています。
Some of the unformalized results could have issues. We will endeavor to fix any such issues quickly.
(形式化されていない結果の中には、問題を含むものがあるかもしれません。そうした問題はできるだけ早く修正するよう努めます。)
なお、Leanが確かめる対象は「書き直した主張と証明」で、元の論文そのものは対象の外にあります。同じ公開の中の別の結果について、Leanの証明を手元で再構築した利用者も、「これが確かめたのはLeanの証明であって、論文ではない」と書き添えています。
確かめること6:どれだけ時間がたったか
発表当日は、判断材料がいちばん少ない日です。過去の「有名問題を証明した」という発表を並べると、そのことがよく分かります。
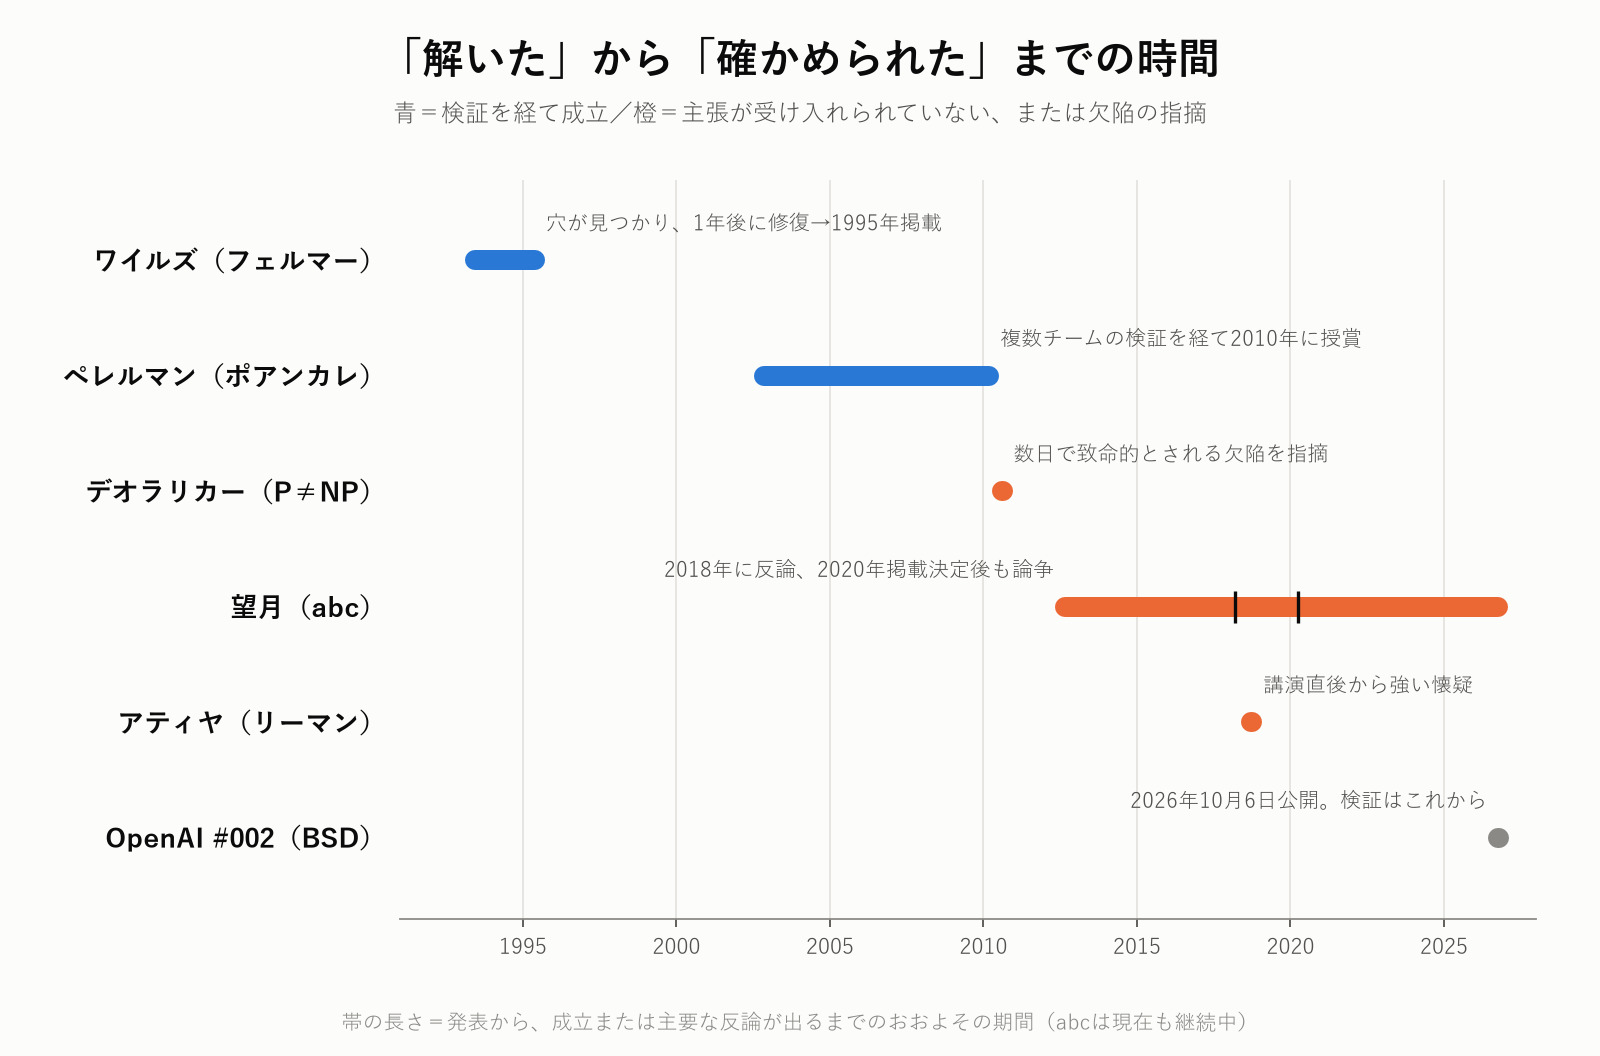
- ワイルズ(フェルマーの最終定理、1993年):発表後の査読で証明に穴が見つかり、修復に約1年かかりました。論文の掲載は1995年です。
- デオラリカー(P≠NP、2010年):公開から数日で、専門家が致命的とされる欠陥を指摘しました。計算機科学者スコット・アーロンソンは、授賞されたら20万ドルを上乗せすると書いて、懐疑を示しました。
- アティヤ(リーマン予想、2018年):フィールズ賞とアーベル賞の受賞者による講演でしたが、数学者ジョン・バエズは「本当に証明したと信じている人を一人も知らない」と述べました。
- 望月新一(abc予想):2018年、ショルツェとスティックスが「証明は存在しない」と結論するノートを公表しました。論文は2020年に掲載が決まりましたが、論争は続いています。
- ペレルマン(ポアンカレ予想):2002〜03年のプレプリントを、複数のチームが何年もかけて検証し、2010年にミレニアム賞の授与が決まりました。
ペレルマンについて、クレイ研究所は授賞の発表で「これらの解説、他のチームによる解説、そして重要なことに、数学界による複数年の精査が、必要な検証をもたらした」と記しています。望月の例が示すように、掲載されたことと、受け入れられたことは別です。クレイの賞の規程(2018年改訂)も、この2つを分けて条件にしています。
b. at least two (2) years have elapsed since publication of the Proposed Solution in a Qualifying Outlet; c. the Proposed Solution has achieved general acceptance in the global mathematics community
(b. 適格な発表媒体での発表から少なくとも2年が経過していること。c. 解決案が世界の数学界で一般的な受容を得ていること。)
「だれの功績か」が決まるまでにも時間がかかります。9月にOpenAIがナビエ–ストークス方程式の問題を解いたと発表した際には、先行する人間の研究者との関係をめぐって論争が起きました。クレイの公式問題記述の執筆者チャールズ・フェファーマンは、米誌Quanta Magazineの記事で「この物語の英雄は、コルドバとマルティネス=ソロアだ」と語っています。
一方で、時間をかけた検証が、AIの成果を裏付ける方向に働くこともあります。OpenAIが8月に発表した10件の結果については、外部の研究者がレビュー記録を監査し、主結果について確認された実質的な誤りは残っていない、と報告しました。ただし同じ論文は、レビューの深さにはばらつきがあるとしたうえで、確信は形式的な検査、人間による再構成、独立した数学的利用、公開された記録を組み合わせて得るべきだ、と結んでいます。
仕事のニュースにも同じ6つの問いが使える
この6つの問いは、数学の外でも役に立ちます。「業界初の完全自動化」「精度99%」「AIが専門家に勝った」といった、仕事の現場に届く発表にもそのまま使えます。
- どこまで:「完全」は、どの条件の範囲での完全か。
- 問題文:自社が本当に解きたい課題と、発表が解いた課題は同じか。
- だれが:発表した会社以外に、確かめた人はいるか。
- 何の上に:その成果は、まだ公開されていない部品や、検証されていない前提に乗っていないか。
- どこまで機械で:「テスト済み」は、全体の何割を、どう数えた数字か。
- 時間:発表から、どれだけの実地の検証期間を経ているか。
今回の件で印象的なのは、範囲をいちばん正直に書いていたのが、ほかならぬOpenAIの論文そのものだったことです。「この仮定は範囲にとって欠かせない」という一文も、「問題があるかもしれない」という注意書きも、原典にはきちんと書かれていました。
範囲は、見出しになる途中で抜け落ちます。
信頼できる発表とは、自分の限界を書いている発表です。そして、その限界の一文までたどり着けるかどうかは、読む側に委ねられています。
まとめ:「解いた」の前に6つの問いを
OpenAIのNo.002は、BSD予想の「浅い丘」について、すべての曲線・すべての素数で精密な公式が成り立つと主張する、大きな前進の候補です。同時に、ランク2以上の「深い山」は範囲の外に置き、自社の未検証の論文を土台にし、Leanの検査と第三者の検証はどちらも受ける前の段階です。
どちらか一方だけを見れば、「ついに解けた」とも「誇大広告だ」とも言えてしまいます。6つの問いを通すと、そのどちらでもない、正確な大きさが見えてきます。
ミレニアム懸賞の100万ドルが動くのは、規程上、適格な媒体に掲載されてから早くても2年後です。見出しを信じるかどうかは、確かめる材料がそろうのを待ってから決められます。
参考文献
- 今井翔太氏の投稿(X)
- Andrew Curran の投稿(X)
- Which Millennium Prize Problem will be solved next? 市場データ(Kalshi API)
- openai/math README・CONTENTS(GitHub)
- Exact Birch–Swinnerton-Dyer Formula from Low Selmer Corank(OpenAI、GitHub)
- Lean形式化カタログ formalization.yaml(OpenAI、GitHub)
- Sharing AI progress in mathematics(OpenAI)
- The Birch and Swinnerton-Dyer Conjecture 公式問題記述(クレイ数学研究所)
- Birch and Swinnerton-Dyer Conjecture(クレイ数学研究所)
- Millennium Prize Rules(クレイ数学研究所)
- ポアンカレ予想 授賞プレスリリース(クレイ数学研究所)
- The Birch and Swinnerton-Dyer conjecture implies Goldfeld's conjecture(Alexander Smith、arXiv)
- The Congruent Number Problem(Keith Conrad)
- The OpenAI problem dump(Persiflage)
- On OpenAI's release of mathematical results(AGMAI)
- Terence Tao の投稿(Mathstodon)
- Pierre Colmez の投稿(X)
- Birch and Swinnerton-Dyer 'Solved Before 2045?' Odds Jump 38 Points on Kalshi(Tech Insider)
- First look at mathematics manuscripts from an internal frontier model at OpenAI(OpenAI Developer Community)
- A Human Audit of OpenAI's AI-Generated Mathematical Proofs(arXiv)
- Why abc is still a conjecture(Scholze・Stix)
- Retired mathematician rocks math world with claim that he's solved $1 million problem(NBC News)
- Deolalikar の P≠NP に関する賭け(Shtetl-Optimized)
- Fatal Flaws in Deolalikar's Proof?(Gödel's Lost Letter and P=NP)
- How Math's Most Famous Proof Nearly Broke(Nautilus)
- AI Has Solved One of Math's $1 Million Millennium Prize Problems(Quanta Magazine)
- OpenAI Says Unreleased AI Model Has Solved 372 Maths Problems(ETV Bharat)